Z ChatGPT korzysta 800 mln aktywnych użytkowników tygodniowo — ogłosił Sam Altman na OpenAI DevDay w październiku 2025 (TechCrunch, 2025). Coraz częściej to model językowy, a nie wyszukiwarka, opowiada Twoim klientom o Twojej marce. Ten tekst wyjaśnia — bez matematyki — jak duży model językowy działa, skąd „wie” (albo nie wie) o Twojej firmie i co z tego wynika dla treści, które publikujesz.
Czym jest duży model językowy (LLM)?
Model językowy (LLM, ang. large language model) to system AI, który generuje tekst, przewidując najbardziej prawdopodobny kolejny fragment wypowiedzi — to on jest silnikiem ChatGPT, Gemini, Claude’a i podobnych narzędzi. LLM nie jest bazą danych ani wyszukiwarką: nie przechowuje stron internetowych, tylko wzorce językowe wyuczone z ogromnych zbiorów tekstu. Gdy pytasz go o cokolwiek, nie „wyszukuje” odpowiedzi — komponuje ją słowo po słowie na podstawie tych wzorców.
Przymiotnik „duży” odnosi się do liczby parametrów, czyli wewnętrznych „pokręteł”, w których model zapisuje wyuczone zależności. GPT-3 — model, który zapoczątkował obecną falę — miał 175 miliardów parametrów, dziesięciokrotnie więcej niż jakikolwiek wcześniejszy nierozrzedzony model językowy (Brown i in., paper GPT-3, 2020). Skala parametrów to definicyjna cecha „dużego” modelu: im więcej wzorców model pomieści, tym płynniej pisze i tym więcej wiedzy o świecie „przy okazji” zapamiętuje.
Dla marketera kluczowa jest jedna konsekwencja tej architektury: LLM zawsze wygeneruje płynną odpowiedź — także wtedy, gdy nie ma faktów, na których mógłby ją oprzeć. Na modelach językowych zbudowane są silniki generatywne — systemy, które odpowiadają użytkownikowi wygenerowaną odpowiedzią zamiast listą linków (ChatGPT, Perplexity, Google AI Overviews, Copilot). To w ich odpowiedziach Twoja marka jest dziś wymieniana, cytowana — albo pomijana.
Skąd LLM „wie” o Twojej marce: trening czy grounding?
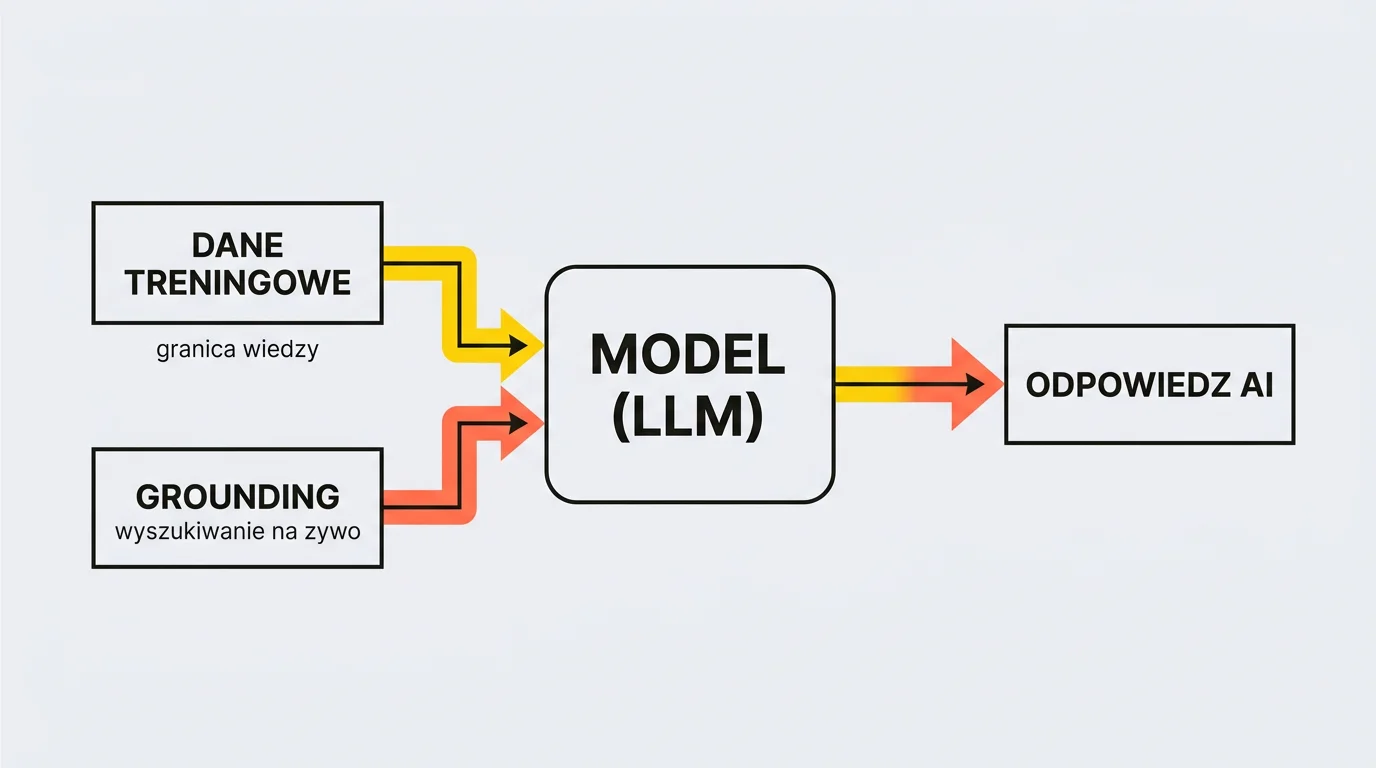
LLM czerpie wiedzę o Twojej marce z dwóch rozłącznych źródeł: z danych treningowych (wiedza zamrożona w czasie) albo z groundingu, czyli wyszukiwania na żywo w trakcie generowania odpowiedzi. Rozróżnienie tych dwóch mechanizmów to najważniejsza rzecz, jaką marketer musi zrozumieć w działaniu LLM.
Trening odbywa się raz, na zbiorze tekstów zebranych do określonej daty — tzw. granicy wiedzy (knowledge cutoff). Przykład: modele Gemini 3 mają granicę wiedzy w styczniu 2025 — zdarzeń późniejszych model nie zna, o ile nie sięgnie do wyszukiwania (dokumentacja Google AI for Developers, stan na lipiec 2026). Jeśli Twoja marka pojawiała się w internecie rzadko albo powstała po dacie treningu, model po prostu jej „nie pamięta” — a zapytany, może pomylić ją z inną lub zmyślić szczegóły.
Grounding to opieranie odpowiedzi modelu na bieżących wynikach wyszukiwania lub indeksie, zamiast wyłącznie na wiedzy z treningu. Według dokumentacji Google grounding łączy model z treścią sieci w czasie rzeczywistym, ogranicza halucynacje przez oparcie odpowiedzi na informacjach ze świata rzeczywistego, dodaje cytowania źródeł i pozwala odpowiadać na pytania wykraczające poza granicę wiedzy modelu (Google, Grounding with Google Search, stan na lipiec 2026). W praktyce: ChatGPT search opiera grounding m.in. o indeks Bing i własny indeks budowany przez bota OAI-SearchBot, a Microsoft Copilot jest oficjalnie groundowany przez Bing — widzi wyłącznie strony zindeksowane w Bing (OpenAI Help, ChatGPT search, stan na lipiec 2026).
Z perspektywy marki są więc trzy scenariusze:
- Marka jest w danych treningowych — model odpowiada „z pamięci”: szeroko, ale według stanu sprzed granicy wiedzy i bez gwarancji poprawności szczegółów.
- Marka jest w indeksach wyszukiwania (Bing, Google, indeksy własne silników) — grounding może pobrać Twoje treści na żywo i zacytować je jako źródło.
- Marki nie ma ani w treningu, ani w indeksach — model milczy o niej albo zgaduje. Dla silnika generatywnego taka marka nie istnieje.
Czym są tokeny i okno kontekstu?
Token to podstawowa jednostka, w której LLM czyta i pisze tekst — fragment słowa, całe słowo lub znak interpunkcyjny. Według oficjalnej dokumentacji OpenAI 1 token to w przybliżeniu 4 znaki lub 0,75 słowa tekstu angielskiego, czyli 100 tokenów odpowiada około 75 słowom (dokumentacja OpenAI API, stan na lipiec 2026). W tokenach liczone są limity, koszty API i długość tego, co model może jednorazowo przetworzyć — dlatego to słowo pojawia się w każdej rozmowie technicznej o AI.
Okno kontekstu to „pamięć robocza” modelu: maksymalna ilość tekstu, którą widzi naraz — Twoje pytanie, załączone dokumenty, wyniki wyszukiwania z groundingu i dotychczasową rozmowę. Gemini 3 Pro przyjmuje 1 mln tokenów wejścia (i do 64 tys. tokenów wyjścia) — według dokumentacji Google to mniej więcej 8 przeciętnych powieści po angielsku albo transkrypcje ponad 200 odcinków podcastów (Google, Long context, stan na lipiec 2026). Duże okno nie oznacza jednak równej uwagi: recenzowane badanie „Lost in the Middle” wykazało krzywą U — modele najlepiej wykorzystują informacje z początku i końca kontekstu, a istotnie gorzej te ze środka długiego tekstu (Liu i in., TACL, 2024). Wniosek dla treści: najważniejsze fakty i odpowiedzi umieszczaj na początku strony i na początku sekcji.
Dlaczego LLM halucynuje i czemu fakty ze źródłami wygrywają?
LLM halucynuje — czyli podaje zmyślone informacje z pełnym przekonaniem — bo jego trening nagradza płynne zgadywanie, a nie przyznanie się do niewiedzy. Według paperu badaczy OpenAI halucynacje powstają jako naturalne błędy na etapie pretreningu i utrzymują się, ponieważ standardowe procedury treningu i ewaluacji „nagradzają zgadywanie zamiast przyznawania niepewności” — benchmarki punktują trafny strzał wyżej niż odpowiedź „nie wiem” (Kalai i in., OpenAI, 2025).
Skala zjawiska jest mierzalna:
| Badanie | Wynik | Warunki pomiaru |
|---|---|---|
| Stanford — Dahl i in., Journal of Legal Analysis, 2024 | halucynacje: GPT-4 58%, GPT-3.5 69%, Llama 2 88% odpowiedzi | ponad 800 000 weryfikowalnych pytań prawnych; modele generacji 2023, bez groundingu |
| NewsGuard, audyt roczny, 2025 | 35% odpowiedzi z fałszywym twierdzeniem (rok wcześniej: 18%) | 10 czołowych chatbotów (m.in. ChatGPT, Gemini, Claude, Copilot, Perplexity); tematy newsowe |
Audyt NewsGuard pokazuje też drugą stronę groundingu: po wdrożeniu wyszukiwania w czasie rzeczywistym odsetek odmów odpowiedzi spadł z 31% do 0% (NewsGuard, 2025). Model podłączony do sieci odpowiada zawsze — a jakość odpowiedzi zależy od jakości źródeł, które znajdzie. Jeśli w indeksie na dany temat są tylko treści mgliste i bez dat, model dostaje słaby materiał; jeśli znajdzie jednoznaczne fakty z liczbą, datą i podanym źródłem, ma co zacytować i na czym oprzeć odpowiedź. Dokumentacja Google wprost wymienia cytowanie weryfikowalnych źródeł jako funkcję groundingu (Google, stan na lipiec 2026).
Model językowy nie odróżnia prawdy od fałszu — odróżnia treści łatwe do bezpiecznego zacytowania od trudnych. Marka, która publikuje jednoznaczne fakty z liczbą, datą i źródłem, obniża modelowi koszt zacytowania jej — i wygrywa z marką, która pisze ogólnikami.
Co z tego wynika dla treści Twojej marki?
Wniosek jest praktyczny: skoro trening jest zamrożony, a grounding działa na żywo, to o widoczności marki w odpowiedziach AI decyduje dziś treść dostępna dla botów, jednoznaczna i podparta źródłami. Właśnie tym zajmuje się GEO (Generative Engine Optimization) — metoda tworzenia i optymalizacji treści tak, aby były cytowane i wykorzystywane w odpowiedziach generowanych przez AI. Z działania LLM wynikają konkretne priorytety:
- Odpowiadaj na początku. Skoro modele najlepiej wykorzystują informacje z początku kontekstu (Liu i in., 2024), pierwsze zdanie każdej sekcji powinno nieść odpowiedź, a nie rozgrzewkę.
- Podawaj fakty z liczbą, datą i źródłem. W recenzowanym eksperymencie GEO dodanie statystyk, cytatów i przywołań źródeł zwiększało widoczność treści w odpowiedziach generatywnych do ok. 40% względnie, a upychanie słów kluczowych ją pogarszało (Aggarwal i in., KDD 2024); niezależna replikacja tego efektu nie potwierdziła (C-SEO Bench, NeurIPS 2025) — precyzyjne, źródłowane fakty traktuj więc jako standard wiarygodności, nie jako gwarantowany „trik na +40%”.
- Zadbaj o indeksację — także w Bing. Copilot widzi wyłącznie strony zindeksowane w Bing, a ChatGPT search korzysta m.in. z indeksu Bing (OpenAI Help, stan na lipiec 2026). Strona niewidoczna dla botów nie istnieje dla groundingu.
- Buduj wzmianki poza własną stroną. Około 84% cytowań w odpowiedziach AI pochodzi z earned media — źródeł trzecich, nie z treści własnych marek (Muck Rack, 2026, próba 25M+ linków).
- Aktualizuj treści. AI-asystenci cytują treści średnio o 25,7% świeższe niż organiczne wyniki Google (Ahrefs, 2025, próba 16,975 mln URL-i) — a fakty bez kotwicy czasu szybko stają się dezinformacją.
Jak przełożyć te zasady na kompletną strategię, opisujemy krok po kroku w przewodniku po GEO (Generative Engine Optimization), a różnice względem klasycznego pozycjonowania — we wpisie GEO vs SEO: co się zmienia.
Nie wiesz, czy ChatGPT, Gemini i Perplexity w ogóle znają Twoją markę — i co o niej mówią? Dokładnie to mierzy audyt widoczności w AI: umów bezpłatną rozmowę, a sprawdzimy, w których odpowiedziach pojawia się Twoja firma.
Słowniczek: 8 pojęć, które musisz znać
Te osiem pojęć wystarczy, żeby rozumieć większość dyskusji o widoczności marki w AI i świadomie rozmawiać z agencją czy zespołem.
- Model językowy (LLM) — duży model językowy; system AI generujący tekst, silnik ChatGPT, Gemini, Claude’a i podobnych.
- Silnik generatywny — system odpowiadający użytkownikowi wygenerowaną odpowiedzią zamiast listą linków (ChatGPT, Perplexity, Google AI Overviews, Copilot).
- Grounding — opieranie odpowiedzi modelu na bieżących wynikach wyszukiwania/indeksie, zamiast wyłącznie na wiedzy z treningu.
- GEO (Generative Engine Optimization) — metoda tworzenia i optymalizacji treści tak, aby były cytowane i wykorzystywane w odpowiedziach generowanych przez AI.
- AI Overviews — generowane przez AI podsumowania nad wynikami wyszukiwania Google.
- Cytowanie (w odpowiedzi AI) — wskazanie strony jako źródła w odpowiedzi silnika generatywnego (link lub przypis).
- Wzmianka marki — wystąpienie nazwy marki w treści odpowiedzi AI, niezależnie od cytowania źródła.
- Ghost citation — cytowanie URL-a strony bez wymienienia marki w treści odpowiedzi.
FAQ: najczęstsze pytania o LLM
Czy LLM to to samo co wyszukiwarka?
Nie. Wyszukiwarka znajduje i szereguje istniejące strony; model językowy (LLM) generuje nowy tekst na podstawie wzorców z treningu. Silniki generatywne łączą oba mechanizmy przez grounding: najpierw wyszukują treści w indeksie (np. ChatGPT search m.in. w indeksie Bing — OpenAI Help, stan na lipiec 2026), a potem model pisze odpowiedź na ich podstawie.
Dlaczego ChatGPT nie zna mojej firmy?
Najczęściej z trzech powodów: marka pojawiała się w danych treningowych zbyt rzadko, powstała po granicy wiedzy modelu (dla Gemini 3 to styczeń 2025 — dokumentacja Google, stan na lipiec 2026) albo jej strona nie jest zindeksowana tam, gdzie sięga grounding. Pierwszym krokiem jest sprawdzenie indeksacji w Bing i Google oraz liczby wzmianek o marce w niezależnych źródłach.
Czy LLM podaje źródła swoich odpowiedzi?
Tylko przy włączonym groundingu — wtedy silnik dodaje cytowania stron, z których korzystał (dokumentacja Google, stan na lipiec 2026). Uwaga: cytowanie nie oznacza wzmianki marki. Według badania Semrush i Kevina Indiga 61,7% cytowań w odpowiedziach AI to ghost citations — URL strony jest podany jako źródło, ale marka nie pada w tekście odpowiedzi (Semrush, 2026).
