Czym jest Perplexity i jak działa?
Perplexity to darmowy silnik odpowiedzi (answer engine) oparty na AI, który — według własnej definicji firmy — „dostarcza dokładne, wiarygodne odpowiedzi w czasie rzeczywistym na dowolne pytanie” (Perplexity, strona główna, stan na lipiec 2026). Zamiast listy dziesięciu niebieskich linków użytkownik dostaje gotową, kilkuakapitową odpowiedź z przypisami do źródeł. To modelowy przykład silnika generatywnego — systemu, który odpowiada wygenerowaną treścią zamiast rankingiem stron.
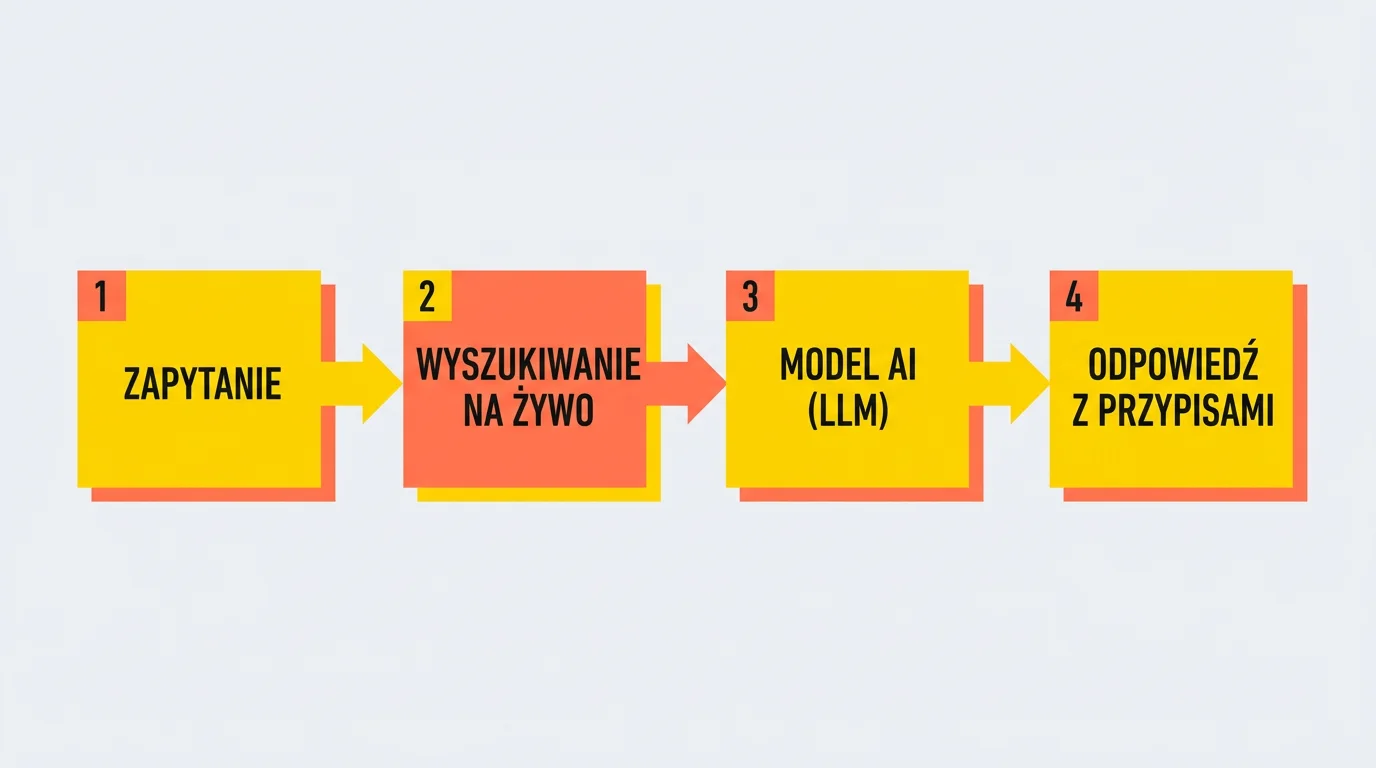
Mechanika jest opisana wprost w oficjalnej dokumentacji: Perplexity „łączy wyszukiwanie sieci na żywo z wieloma wiodącymi modelami AI, aby dawać aktualne odpowiedzi poparte cytowaniami, które można zweryfikować” (Perplexity Hub, Getting started, stan na lipiec 2026). W praktyce oznacza to trzy kroki: system wyszukuje bieżące strony pod zadane pytanie, model językowy (LLM) syntetyzuje z nich odpowiedź, a każde kluczowe zdanie dostaje numerowany przypis do konkretnego URL-a. Ten mechanizm — grounding, czyli opieranie odpowiedzi na bieżącym indeksie zamiast wyłącznie na wiedzy z treningu — jest w Perplexity domyślny, nie opcjonalny.
Skala nie jest już niszowa. Według danych CEO Aravinda Srinivasa z Bloomberg Tech Summit Perplexity obsłużyło 780 mln zapytań w maju 2025 roku — około 30 mln dziennie, przy wzroście ponad 20% miesiąc do miesiąca; pierwszego dnia działania w 2022 roku było to 3000 zapytań (TechCrunch, 2025). Dla marketera wniosek jest prosty: to realny kanał, w którym użytkownicy zadają pytania zakupowe i informacyjne — i w którym Twoja marka albo jest cytowana, albo nie istnieje.
Czym Perplexity różni się od ChatGPT i Google?
Perplexity różni się od ChatGPT domyślnym wyszukiwaniem i widocznymi przypisami przy każdej odpowiedzi, a od Google — tym, że odpowiedź zastępuje ranking, zamiast go uzupełniać. Najkrócej pokazuje to porównanie:
| Cecha | Google (wyniki organiczne) | ChatGPT | Perplexity |
|---|---|---|---|
| Podstawowy produkt | ranking linków (+ AI Overviews) | rozmowa z modelem | odpowiedź z przypisami |
| Dostęp do sieci na żywo | tak (własny indeks) | opcjonalny (tryb wyszukiwania) | domyślny, przy każdym zapytaniu |
| Cytowania źródeł | brak (link = wynik) | tylko w trybie wyszukiwania | zawsze, numerowane przy zdaniach |
| Co decyduje o widoczności marki | pozycja w rankingu | wiedza modelu + grounding | wybór strony jako źródła cytowania |
Różnice widać też w danych o źródłach. Badanie Ahrefs na 15 000 zapytań long-tail wykazało, że Perplexity trzyma się wyników Google najbliżej ze wszystkich chatbotów: 28,6% jego cytowań pochodzi z top-10 Google dla danego zapytania — wobec 8,6% u Copilota, 8,2% u Gemini i 8,0% u ChatGPT; jednocześnie około 80% cytowań chatbotów w ogóle nie rankuje w Google dla oryginalnego zapytania (Ahrefs, 2025). Silne SEO pomaga więc w Perplexity bardziej niż w innych silnikach, ale nie wystarcza — większość cytowanych stron pochodzi spoza rankingu. Na czym polega ta zmiana reguł, opisujemy szerzej we wpisie GEO vs SEO — co się zmienia.
Perplexity premiuje też świeżość mocniej niż organiczny Google: średni wiek strony cytowanej przez Perplexity to 1166 dni od publikacji wobec 1432 dni w wynikach organicznych; asystenci AI ogółem cytują treści o 25,7% świeższe (Ahrefs, 2025, analiza 16,975 mln cytowanych URL-i). Inny jest również profil domen: w analizie Profound obejmującej 680 mln cytowań (sierpień 2024 – czerwiec 2025) najczęściej cytowaną domeną w Perplexity był Reddit z udziałem 6,6%, podczas gdy w ChatGPT numerem jeden była Wikipedia z 7,8% (Profound, 2025). Zastrzeżenie: wzorce źródeł różnią się między silnikami i zmieniają w czasie, więc traktuj te liczby jako migawkę z tamtego okresu, nie stałą regułę.
Czym jest PerplexityBot i jak wpuścić go na stronę?
PerplexityBot to crawler indeksujący Perplexity — według oficjalnej dokumentacji służy do „wynajdywania i linkowania stron w wynikach wyszukiwania Perplexity”, nie zbiera treści do trenowania modeli fundacyjnych i respektuje robots.txt (Perplexity Docs, Perplexity crawlers, stan na lipiec 2026). Jeśli chcesz być cytowany w odpowiedziach, ten bot musi mieć wstęp na stronę. Minimalna konfiguracja:
- Przepuść bota w robots.txt: sekcja
User-agent: PerplexityBotz dyrektywąAllow: /(lub bez blokującychDisallowdla treści, na których cytowaniu Ci zależy). - Sprawdź blokady na poziomie serwera i WAF: firewall, CDN lub reguły anty-bot potrafią odcinać crawlery AI niezależnie od robots.txt.
- Weryfikuj po IP, nie tylko po user-agencie: Perplexity publikuje oficjalne zakresy IP bota pod adresem perplexity.com/perplexitybot.json (Perplexity Docs, stan na lipiec 2026) — to jedyny pewny sposób odróżnienia prawdziwego bota od podszywających się skryptów.
- Serwuj treść w czystym HTML: kluczowe informacje renderowane wyłącznie JavaScriptem mogą być dla crawlera niewidoczne.
Perplexity ma też drugiego fetchera: Perplexity-User odwiedza stronę w momencie, gdy użytkownik zadaje pytanie — i według tej samej dokumentacji „generalnie ignoruje” reguły robots.txt, bo wizytę inicjuje człowiek (Perplexity Docs, stan na lipiec 2026). Kto chce realnie blokować Perplexity, musi więc sięgnąć po reguły WAF lub blokady IP, nie po sam robots.txt. Warto przy tym znać kontekst sporu: Cloudflare udokumentował w sierpniu 2025 roku, że Perplexity używał niezadeklarowanych crawlerów „stealth” — z rotacją IP i ASN poza opublikowanymi zakresami oraz user-agentem imitującym Chrome na macOS — do omijania blokad no-crawl; Perplexity zarzutom zaprzeczył (Cloudflare, 2025). Dla marek nastawionych na widoczność praktyczny wniosek pozostaje ten sam: wpuszczać zadeklarowane boty i monitorować logi.
Co widoczność w Perplexity oznacza dla Twojej marki?
Widoczność w Perplexity oznacza bycie cytowanym źródłem, a nie pozycję w rankingu — i to jest fundamentalna zmiana dla marketingu. Cytowanie (w odpowiedzi AI) to wskazanie Twojej strony jako źródła w wygenerowanej odpowiedzi; to o nie toczy się gra, którą opisuje GEO (Generative Engine Optimization) — metoda tworzenia i optymalizacji treści tak, aby były cytowane i wykorzystywane w odpowiedziach generowanych przez AI. Pełne omówienie znajdziesz w naszym przewodniku po Generative Engine Optimization.
Perplexity zamienia wyszukiwanie w rozmowę ze źródłami: o widoczności marki nie decyduje pozycja w rankingu, tylko to, czy silnik uzna Twoją stronę za źródło warte zacytowania.
Co realnie podnosi szansę na cytowanie? Najczęściej przywoływany dowód pochodzi z eksperymentu autorów papieru GEO (KDD 2024) prowadzonego m.in. na produkcyjnym Perplexity.ai: dodanie cytatów podnosiło widoczność treści o około 21% (metryka PAWC), dodanie statystyk o około 37% (metryka Subjective Impression), a keyword stuffing obniżał widoczność o około 10% (Aggarwal i in., GEO, KDD 2024). Ważne zastrzeżenie: niezależna replikacja C-SEO Bench (NeurIPS 2025) tych efektów nie potwierdziła — traktuj je jako przesłankę, nie gwarancję.
Druga rzecz, którą trzeba zrozumieć, to ghost citations: według badania Semrush i Kevina Indiga 61,7% cytowań w odpowiedziach AI to link do strony w źródłach bez wymienienia marki w tekście odpowiedzi; tylko 38,3% cytowań idzie w parze ze wzmianką marki (Semrush, 2026, N=3981 wystąpień domen; badane platformy: ChatGPT, Google AI Overviews, Gemini i Google AI Mode). Badanie nie objęło samego Perplexity, ale rozdział „cytowanie URL-a” kontra „wzmianka marki” dotyczy każdego silnika cytującego źródła — to dwa różne zjawiska i dwa osobne KPI.
Perplexity przestaje też być „tylko wyszukiwarką”. 9 lipca 2025 roku firma uruchomiła przeglądarkę Comet z wbudowanym asystentem AI, początkowo dla subskrybentów planu Max za 200 USD miesięcznie (TechCrunch, 2025). W sierpniu 2025 doszedł Comet Plus za 5 USD miesięcznie — model podziału przychodów z wydawcami, w którym wynagradzane są trzy typy ruchu: wizyty ludzi, cytowania w wyszukiwaniu i akcje agentów AI (Perplexity, 2025); według relacji prasowych pula wynosi 42,5 mln USD, a wydawcy otrzymują 80% przychodów subskrypcyjnych (Digiday, 2025). Kapitał podąża za tą wizją: według doniesień The Information Perplexity sfinalizowało we wrześniu 2025 rundę 200 mln USD przy wycenie 20 mld USD — dwa miesiące po rundzie 100 mln USD przy 18 mld USD (TechCrunch, 2025, brak oficjalnego potwierdzenia).
Jeśli nie wiesz, czy Perplexity w ogóle widzi Twoją markę, sprawdzimy to za Ciebie: audyt widoczności w AI pokazuje, gdzie i jak Twoja domena pojawia się w odpowiedziach silników generatywnych — w tym w Perplexity.
Jak sprawdzić, czy Perplexity cytuje Twoją stronę?
Najprostsza metoda to ręczny test: zadaj w Perplexity zestaw pytań, które zadają Twoi klienci, i sprawdź przypisy w odpowiedziach. Żeby pomiar był rzetelny, a nie anegdotyczny, potrzebujesz czterech elementów:
- Stały zestaw promptów — 30–50 pytań odpowiadających intencjom Twoich klientów, uruchamiany co miesiąc w tym samym brzmieniu, żeby wyniki dało się porównywać w czasie.
- Rozdzielone KPI — osobno licz cytowania Twoich URL-i w źródłach, osobno wzmianki marki w treści odpowiedzi; jak pokazuje badanie Semrush (2026), większość cytowań to ghost citations bez wzmianki.
- Logi serwera — obecność user-agentów PerplexityBot (indeksowanie) i Perplexity-User (wizyty wywołane pytaniami użytkowników) potwierdza, że silnik faktycznie pobiera Twoje strony; weryfikuj żądania po opublikowanych zakresach IP.
- Ruch odsyłający — w analityce filtruj sesje z referrerem perplexity.ai; to bezpośredni dowód, że cytowania przekładają się na kliknięcia.
Jeżeli po takim audycie okaże się, że konkurencja jest cytowana, a Ty nie — to zwykle sygnał braków w treści (brak jednoznacznych faktów, dat i źródeł), a nie w technologii. Od tego zaczyna się praca opisana w przewodniku po GEO.
FAQ: najczęstsze pytania o Perplexity
Czy Perplexity jest darmowe?
Tak — Perplexity definiuje się jako darmowy silnik odpowiedzi oparty na AI (Perplexity, stan na lipiec 2026). Istnieją też plany płatne: najwyższy, Max, kosztował 200 USD miesięcznie i jako pierwszy dawał dostęp do przeglądarki Comet po premierze 9 lipca 2025 (TechCrunch, 2025). Do sprawdzenia, czy Perplexity cytuje Twoją stronę, wystarczy wersja bezpłatna.
Czy blokada w robots.txt zatrzyma Perplexity?
Tylko częściowo. Crawler indeksujący PerplexityBot według oficjalnej dokumentacji respektuje robots.txt, ale fetcher Perplexity-User, działający na żądanie użytkownika, „generalnie ignoruje” te reguły (Perplexity Docs, stan na lipiec 2026). Skuteczna blokada wymaga reguł WAF lub blokad IP na opublikowanych zakresach adresów. Z perspektywy widoczności marki blokowanie jest jednak zwykle strzałem w kolano.
Czy Perplexity korzysta z wyników Google?
Perplexity ma własny indeks i crawler, ale jego cytowania pokrywają się z Google najmocniej ze wszystkich chatbotów: 28,6% źródeł cytowanych przez Perplexity pochodzi z top-10 Google dla danego zapytania — wobec 8,0–8,6% u ChatGPT, Gemini i Copilota (Ahrefs, 2025, 15 000 zapytań). Dobre pozycje w Google zwiększają więc szansę na cytowanie w Perplexity, ale około 70% cytowań pochodzi spoza tego top-10.
