Encja to rozpoznawalna przez maszyny jednostka wiedzy o świecie — marka, osoba, produkt czy miejsce — opisana kanoniczną nazwą i zestawem atrybutów, które powtarzają się spójnie w wielu źródłach. W praktyce „encje seo” oznaczają porządkowanie tego, jak systemy AI rozumieją, kim jest Twoja firma: jedna nazwa, jedna definicja, ten sam obraz w całym korpusie tekstów o marce. Ten poradnik pokazuje, jak zbudować spójny sygnał marki jako encji — od Organization schema i sameAs po Wikidata — i jak zaudytować spójność, którą realnie widzą modele. Kontekst całej dyscypliny znajdziesz w naszym przewodniku po GEO (Generative Engine Optimization) — metodzie tworzenia i optymalizacji treści tak, aby były cytowane i wykorzystywane w odpowiedziach generowanych przez AI.
Czym jest encja marki i skąd model językowy czerpie jej obraz?
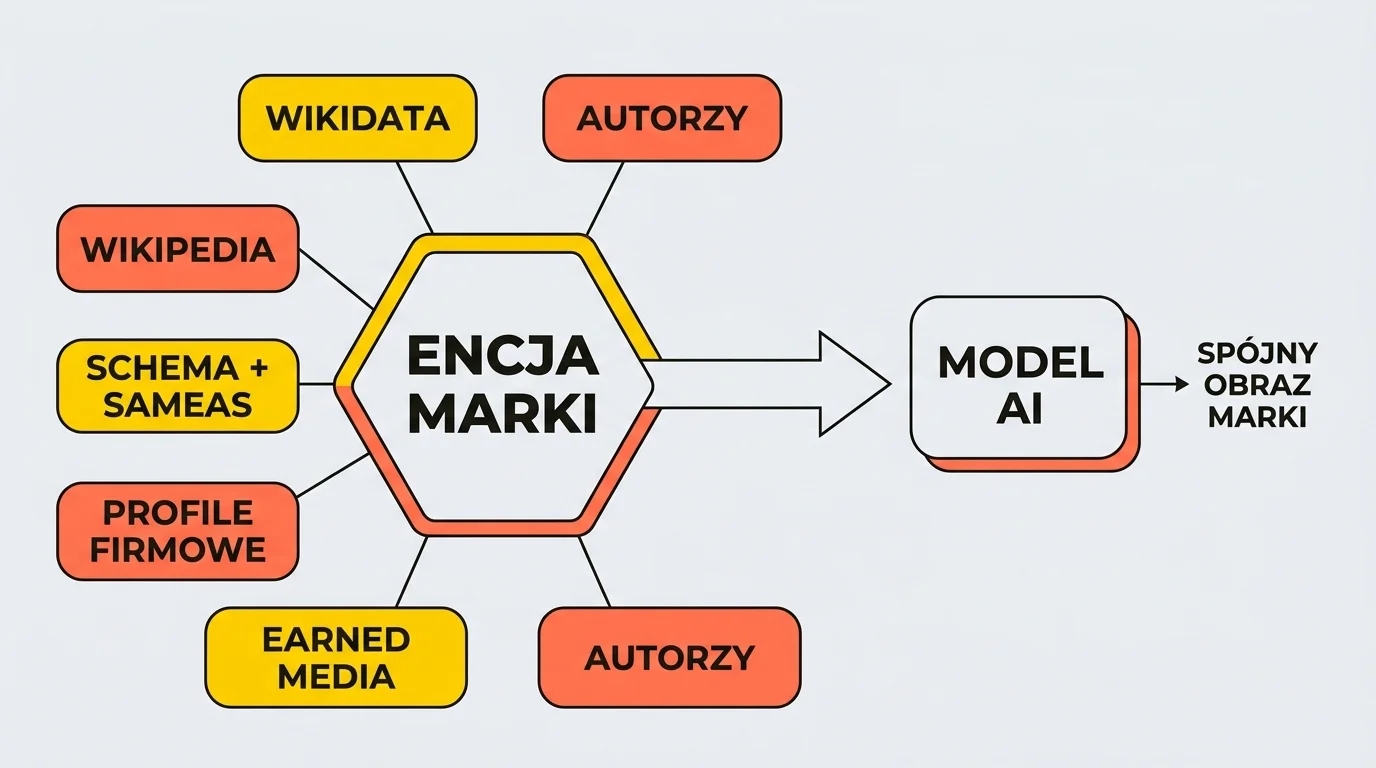
Encja marki to Twoja firma widziana jako węzeł wiedzy — jedna kanoniczna nazwa połączona z faktami (czym się zajmujecie, gdzie działacie, kto stoi za marką) — a model językowy (LLM), czyli duży model generujący tekst, silnik ChatGPT, Gemini czy Claude’a, buduje obraz tej encji przede wszystkim ze źródeł zewnętrznych, nie z Twojej autoprezentacji. To nie jest domysł, tylko wzorzec widoczny w danych o cytowaniach. Cytowanie (w odpowiedzi AI) to wskazanie strony jako źródła w odpowiedzi silnika generatywnego — systemu odpowiadającego wygenerowaną odpowiedzią zamiast listą linków (ChatGPT, Perplexity, Google AI Overviews, Copilot).
Dowody na to, skąd silniki biorą wiedzę o marce, są zgodne:
- Zapytania o marki cytują głównie źródła zewnętrzne. W analizie 23 387 cytowań dla 240 zapytań brandowych w 5 silnikach cytowania z earned media przewyższały treści własne marki ponad dwukrotnie — 48% vs 23% (Omniscient Digital, 2026).
- Silniki generatywne żywią się earned media. W zbiorze ponad 25 mln linków cytowanych przez ChatGPT, Claude’a i Gemini w 17 branżach około 84% cytowań pochodziło z earned media, a treści płatne dały zaledwie 0,3% (Muck Rack, 2026).
- Bazy wiedzy czerpią z setek źródeł. Google opisuje swój Knowledge Graph tak: „We draw from hundreds of sources… Wikipedia is a commonly-cited source, but it’s not the only one” (Google, 2020).
Wniosek dla marki jest praktyczny: nie zbudujesz spójnej encji samą stroną „O nas”. Obraz encji powstaje w korpusie zewnętrznym — i albo jest w nim spójny, albo model dostaje sprzeczne sygnały. Jak silniki dobierają, które z tych źródeł zacytować, rozkładamy w tekście jak LLM wybiera źródła.
Dlaczego spójność opisu marki to hipoteza robocza, a nie zmierzony czynnik?
Bo nie istnieje badanie, które izolowałoby spójność opisu encji jako pojedynczą zmienną i zmierzyło jej wpływ na cytowania w AI — to dobrze uzasadniona hipoteza „konsensusu korpusu”, a nie udowodniony czynnik rankingowy. Uczciwie: mechanizm (modele budują obraz marki ze źródeł zewnętrznych) jest udokumentowany dowodami pośrednimi, ale przeskok „więc spójny opis podnosi cytowania” pozostaje niesprawdzony bezpośrednio (dowód pośredni: Omniscient Digital, 2026). Traktujemy więc spójność encji jako dobrą praktykę o niskim koszcie, nie jako gwarantowaną dźwignię.
Co przemawia za tym, że warto ją porządkować mimo braku badania izolującego:
- Wzmianki o marce korelują z widocznością w AI silniej niż linki. W analizie 75 000 marek liczba niezależnych wzmianek o marce korelowała z widocznością w AI na poziomie 0,656–0,709 (Spearman) wobec 0,218 dla backlinków i 0,266–0,326 dla Domain Rating — około trzy razy silniej (Ahrefs, 2025). Skoro liczą się wzmianki w wielu źródłach, spójny opis w tych wzmiankach jest tanim wzmocnieniem sygnału.
- Mocno cytowane treści są gęste od encji. W badaniu 18 012 zweryfikowanych cytowań z około 3 mln odpowiedzi tekst często cytowany przez ChatGPT miał średnią gęstość encji 20,6% — trzy do czterech razy powyżej normalnej angielszczyzny (Kevin Indig / Search Engine Land, 2026). Jasno nazwane encje to cecha treści, którą modele lubią cytować.
Spójna encja to jedna kanoniczna nazwa i jeden powtarzalny opis marki w całym korpusie, który widzą maszyny — nie sztuczka na cytowania, lecz usunięcie sprzeczności, przez które model musiałby zgadywać, kim jesteś. Koszt jest niski, a downside praktycznie zerowy.
Jak Organization schema i sameAs porządkują tożsamość encji?
Organization schema i właściwość sameAs to sposób, w jaki wprost mówisz maszynom „to jest ta sama organizacja”, łącząc rozproszone profile i strony referencyjne w jedną encję — to higiena tożsamości, nie zadeklarowana dźwignia rankingu. Dane strukturalne (schema.org) to maszynowo czytelne oznaczenia treści; pełnią rolę higieny technicznej, nie mnożnika cytowań. Definicja właściwości sameAs jest jednoznaczna: „URL of a reference Web page that unambiguously indicates the item’s identity. E.g. the URL of the item’s Wikipedia page, Wikidata entry, or official website” (Schema.org, 2026).
Dokumentacja Google potwierdza mechanizm i zarazem studzi oczekiwania: sameAs w Organization structured data to URL strony z dodatkowymi informacjami o organizacji (np. profil w mediach społecznościowych czy serwis z opiniami), można podać wiele takich URL-i — „You can provide multiple sameAs URLs” — a dokument (akt. 15 kwietnia 2026) nie deklaruje żadnej korzyści rankingowej z ich dodania (Google Search Central, 2026). Innymi słowy: sameAs to udokumentowany mechanizm rozstrzygania tożsamości encji i połączenia organizacji z Google Knowledge Graph, ale bez liczbowego dowodu wpływu na cytowania w LLM (Schema.org, 2026).
Sensowny zestaw celów sameAs dla marki obejmuje:
- wpis w Wikidata i (jeśli istnieje) artykuł w Wikipedii — referencyjne bazy tożsamości encji;
- profile firmowe: LinkedIn, X, YouTube, GitHub, Crunchbase;
- oficjalną stronę marki jako kanoniczny adres encji.
Ważne, czego schema nie załatwia. Google stwierdza wprost, że do AI Overviews i AI Mode nie jest potrzebne żadne specjalne schema: „You don’t need to create new machine readable files… There’s also no special schema.org structured data that you need to add” (Google Search Central, 2025). Potwierdza to jedyny duży test przyczynowości: strony cytowane przez AI mają JSON-LD około trzy razy częściej (na próbie 6 mln URL-i), ale quasi-eksperyment (1 885 stron z dodanym schema vs ~4 000 kontrolnych) nie wykazał przyczynowego wzrostu cytowań — AI Overviews −4,6%, AI Mode +2,4% i ChatGPT +2,2% (dwa ostatnie nieistotne statystycznie) (Ahrefs, 2026). Wdrażaj Organization i sameAs jako jednoznaczny sygnał tożsamości, nie jako obietnicę cytowań.
Jaką rolę grają Wikipedia i Wikidata jako sygnały encji?
Wikipedia i Wikidata to jedne z najlepiej udokumentowanych źródeł, z których maszyny rozstrzygają tożsamość encji — silne, lecz nie jedyne. Skala grafu, który je konsumuje, jest duża: Google Knowledge Graph liczył ponad 500 miliardów faktów o 5 miliardach encji według ostatniej oficjalnej liczby (Google, 2020; nowszej statystyki Google nie opublikował). Sama Wikidata — ustrukturyzowana, maszynowo czytelna baza wiedzy zasilająca m.in. Knowledge Graph — zawierała 122 333 094 elementów według stanu na (Wikidata:Statistics, 2026).
Że Wikipedia i Wikidata realnie karmią systemy AI, potwierdza rynek: Wikimedia zawarła w ramach Wikimedia Enterprise komercyjne umowy na dostęp do danych z dużymi firmami AI i tech — wśród partnerów wymienia się Amazon, Google, Meta, Microsoft, Perplexity i Mistral AI (szczegóły finansowe nieujawnione) (The Batch, 2025). To praktyczny argument, by uporządkować wpis w Wikidata: jest to referencyjny cel dla sameAs i dane, które trafiają do korpusu wielu modeli.
Zastrzeżenie proporcji: Wikipedia jest źródłem często cytowanym, ale — słowami Google — „not the only one” (Google, 2020). Brak artykułu w Wikipedii nie wyklucza marki z wiedzy modeli; poprawny, zweryfikowany wpis w Wikidata jest realistyczniejszym pierwszym krokiem niż walka o hasło encyklopedyczne.
Jak przeprowadzić audyt spójności encji marki?
Audyt spójności encji to systematyczne sprawdzenie, czy Twoja kanoniczna nazwa, opis i kluczowe atrybuty są identyczne wszędzie, gdzie widzą je maszyny — a rozbieżności to sprzeczne sygnały, które model musi rozstrzygać zgadywaniem. Zacznij od ustalenia jednej kanonicznej nazwy i jednego zdania definiującego markę, a potem sprawdź spójność po źródłach:
| Obszar | Co sprawdzić | Sygnał spójności |
|---|---|---|
| Kanoniczna nazwa | Czy wszędzie ta sama forma (z „Labs”/bez, spójny zapis, brak wariantów) | Jedna nazwa = jedna encja; warianty rozbijają sygnał |
| Opis marki | To samo zdanie definiujące na stronie, w stopce, About, profilach zewnętrznych | Powtarzalny opis = konsensus korpusu |
| Organization schema + sameAs | Poprawny JSON-LD z kompletem sameAs (Wikidata, social, oficjalny URL) | Jednoznaczne „to ta sama organizacja” |
| Wikidata | Istnienie i poprawność wpisu, spójne etykiety i linki referencyjne | Referencyjny cel tożsamości encji |
| Profile zewnętrzne | LinkedIn, katalogi, media — ta sama nazwa, opis, URL | Spójne earned media wzmacniają węzeł |
| Autorzy | Spójne bio, rola i sameAs osób-autorów marki | Encje osób łączą się z encją marki |
Przy interpretacji audytu rozdziel dwie rzeczy, które łatwo pomylić: cytowanie (link do źródła) i wzmiankę marki (nazwa marki w treści odpowiedzi AI, bez linku). To zjawiska osobne — w analizie 3 981 wystąpień domen aż 61,7% cytowań to „ghost citations”, czyli linki bez wymienienia marki w treści odpowiedzi; z nazwy padło tylko 38,3% (Semrush + Kevin Indig, 2026). Ghost citation to cytowanie URL-a strony bez wymienienia marki w treści odpowiedzi. Spójna encja pomaga zamienić „gościa” w rozpoznaną z nazwy markę — bo model ma jeden, powtarzalny obraz, który może przywołać.
Ten sam audyt spójności encji przeprowadzamy w ramach audytu widoczności w AI — pomiaru, gdzie i jak marka pojawia się w odpowiedziach silników generatywnych. Jeśli chcesz sprawdzić, jak spójny (albo sprzeczny) jest dziś sygnał Twojej marki, zacznij od audytu widoczności w AI. To także naturalny punkt styku z tym, co opisujemy w tekście GEO vs SEO: co naprawdę się zmienia — fundamenty tożsamości przenoszą się do nowego kanału, magiczne skróty nie.
FAQ: encje i spójność semantyczna marki
Czy potrzebuję strony w Wikipedii, żeby AI znało moją markę?
Nie. Bazy wiedzy zasilające modele czerpią z setek źródeł, a Wikipedia jest „commonly-cited source, but it’s not the only one” (Google, 2020). Realistyczniejszym pierwszym krokiem jest poprawny wpis w Wikidata (122 mln elementów, stan na 8 lipca 2026 — Wikidata, 2026) oraz niezależne wzmianki o marce, które korelują z widocznością w AI silniej niż backlinki (Ahrefs, 2025).
Czy dodanie sameAs zwiększy cytowania mojej marki w AI?
Brak na to dowodu liczbowego. sameAs to udokumentowany mechanizm rozstrzygania tożsamości encji i łączenia jej z Knowledge Graph (Schema.org, 2026), ale dokumentacja Google nie deklaruje korzyści rankingowej z jego dodania (Google Search Central, 2026), a jedyny duży eksperyment nie wykazał przyczynowego wzrostu cytowań po dodaniu schema (Ahrefs, 2026). Wdrażaj sameAs jako higienę tożsamości, nie jako obietnicę cytowań.
Co jest ważniejsze dla spójności encji — schema czy wzmianki w innych źródłach?
Źródła zewnętrzne. Google potwierdza, że do funkcji AI nie jest potrzebne żadne specjalne schema (Google Search Central, 2025), a wzmianki o marce korelują z widocznością w AI około trzy razy silniej niż backlinki (Ahrefs, 2025). Schema i sameAs to tania higiena tożsamości; ciężar sygnału niesie spójny, powtarzalny opis marki w wielu niezależnych źródłach — i to on jest hipotezą „konsensusu korpusu”, którą warto porządkować mimo braku badania izolującego (Omniscient Digital, 2026).