Grounding to opieranie odpowiedzi modelu na bieżącym indeksie lub wynikach wyszukiwania, zamiast wyłącznie na wiedzy z treningu. To dlatego ChatGPT potrafi odpowiedzieć na pytanie o wydarzenie sprzed godziny, mimo że jego dane treningowe są zamrożone miesiące wcześniej — w momencie odpowiedzi model dobiera świeże strony z indeksu, który sam odpytuje. Że grounding realnie sięga po aktualne treści widać w danych: cytowania asystentów AI są średnio o 25,7% świeższe niż wyniki organiczne Google (Ahrefs, lipiec 2025). Ten artykuł tłumaczy, jak grounding działa w ChatGPT, Copilocie, Perplexity i AI Overviews — i co z tego wynika dla widoczności marki. Stan na .
Dlaczego model „wie” o świeżych rzeczach, skoro trening jest zamrożony?
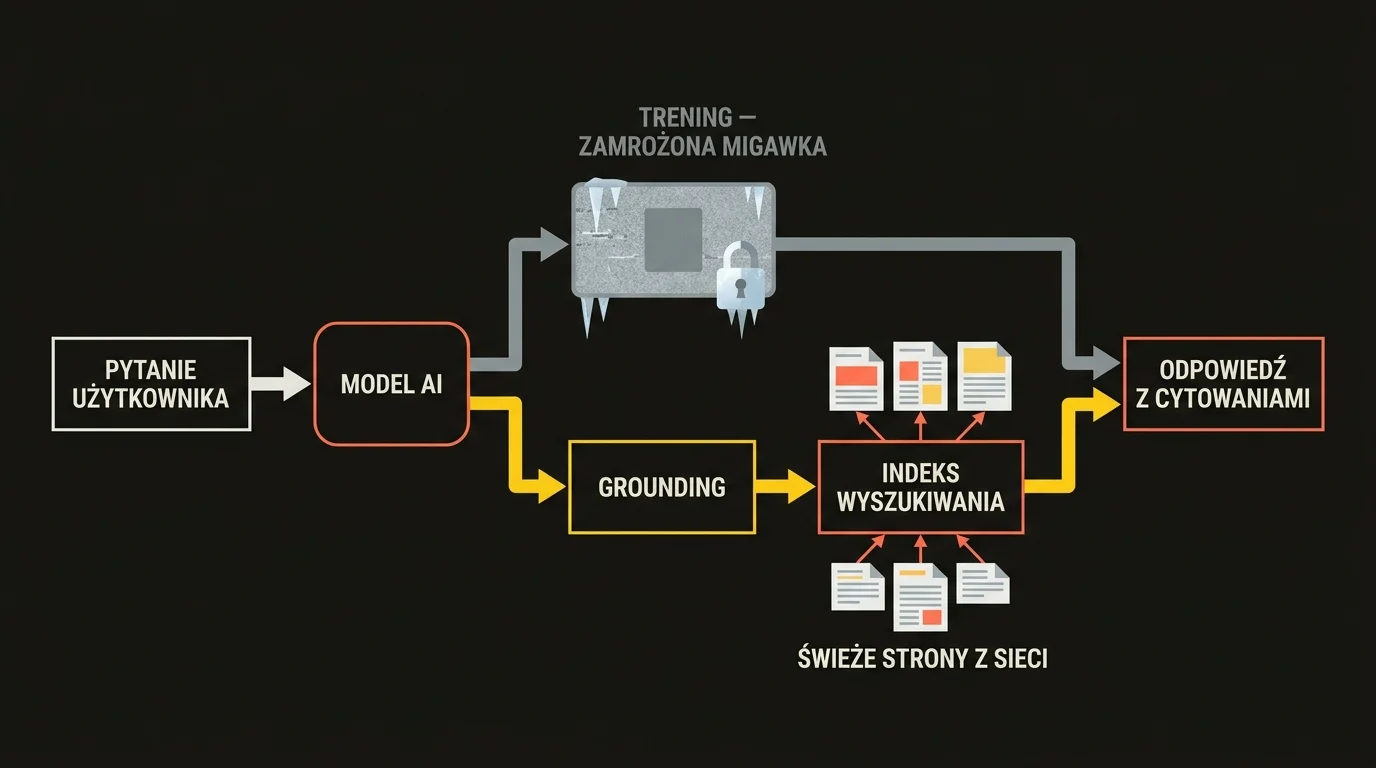
Model nie „wie” o wczorajszych wydarzeniach z treningu — dostaje je przez grounding, czyli pobranie (retrieval) aktualnych stron z indeksu w chwili generowania odpowiedzi. Trening to jednorazowa migawka wiedzy zamknięta w wagach modelu i szybko się starzejąca; grounding to osobny proces, który w czasie rzeczywistym dokłada do promptu bieżące treści z sieci. Microsoft opisuje web search w Copilocie wprost jako „grounding them in the latest information from the web” — czyli osadzanie odpowiedzi w najświeższych informacjach z internetu (Microsoft, dokumentacja Microsoft 365 Copilot, maj 2026).
Że trening i grounding to dwa rozdzielne mechanizmy, najlepiej widać po infrastrukturze crawlerów. OpenAI prowadzi trzy osobne boty o różnych funkcjach: GPTBot pobiera treści do treningu modeli, OAI-SearchBot buduje indeks wyszukiwania ChatGPT, a ChatGPT-User pobiera stronę na żądanie użytkownika (OpenAI, dokumentacja botów, lipiec 2026). Można zablokować trening, a nadal zostać w indeksie groundingu — albo odwrotnie. Dla marki liczy się przede wszystkim ten drugi, bo to on decyduje o obecności w bieżących odpowiedziach.
Jak działa grounding w wyszukiwaniu ChatGPT?
Wyszukiwanie w ChatGPT grounduje odpowiedź na indeksie, który OpenAI samo odpytuje — a nie na tym, co model „pamięta”. Ten indeks w istotnym stopniu opiera się o indeks Bing, ale już nie wyłącznie: OpenAI utrzymuje własny indeks budowany przez OAI-SearchBot, korzysta z zewnętrznych dostawców wyszukiwania, a w wersjach płatnych widać poszlaki sięgania do Google. Dla planów Enterprise i Edu Bing deklarowany jest jako jedyny zewnętrzny dostawca (ChatGPT Search, OpenAI Help Center, lipiec 2026). Teza „ChatGPT = wyłącznie Bing” jest więc już nieaktualna.
Kluczowa konsekwencja jest binarna: jeśli Twojej strony nie ma w indeksie groundingu, nie pojawi się ona w odpowiedziach — niezależnie od jakości treści. OpenAI ujmuje to jednoznacznie: „Sites that are opted out of OAI-SearchBot will not be shown in ChatGPT search answers”, czyli strony wykluczone z OAI-SearchBot nie zostaną pokazane w odpowiedziach wyszukiwania ChatGPT (OpenAI, dokumentacja botów, lipiec 2026). Obecność w indeksie, który model odpytuje, jest warunkiem koniecznym widoczności — dopiero potem ważą się treść i dopasowanie. Mechanikę doboru samych źródeł rozkładamy na czynniki w tekście jak ChatGPT wybiera źródła.
Jak grounduje się Copilot, Perplexity i Claude?
Każdy asystent z wyszukiwaniem grounduje przez jakiś indeks — różnią się tym, przez który i jak ściśle. Microsoft 365 Copilot jest groundowany wyłącznie przez Bing: gdy web search jest włączony, Copilot generuje zapytanie, wysyła je do usługi Bing i komponuje odpowiedź z otrzymanych wyników (Microsoft, dokumentacja Microsoft 365 Copilot, maj 2026). Tu warunek jest twardy i pojedynczy — bez indeksacji w Bing strona w Copilocie nie istnieje. Rozwijamy to w tekście Copilot i rola Binga.
Warto wiedzieć, że zapytanie groundujące nie jest kopią Twojego promptu. Copilot parsuje prompt, wybiera z niego terminy i tworzy kilkuwyrazowe zapytanie do wyszukiwarki: „This generated search query is different from the user’s original prompt — it consists of a few words informed by the user’s prompt” (Microsoft, dokumentacja Microsoft 365 Copilot, maj 2026). To znaczy, że musisz być odnajdywalny pod krótkimi, rdzeniowymi frazami, a nie pod całym długim pytaniem użytkownika.
Pozostali dostawcy powielają wzorzec „osobny bot do treningu, osobny do groundingu”:
- Perplexity rozdziela boty: PerplexityBot indeksuje strony do wyników wyszukiwania (deklaratywnie nie do treningu modeli), a Perplexity-User pobiera stronę na żądanie użytkownika i — jak zaznacza dokumentacja — generalnie ignoruje robots.txt (Perplexity, dokumentacja crawlerów, lipiec 2026).
- Anthropic (Claude) również rozdziela trening od groundingu: ClaudeBot pobiera treści do treningu, Claude-SearchBot indeksuje strony na potrzeby wyszukiwania Claude, a Claude-User pobiera stronę na żądanie użytkownika (Anthropic, centrum pomocy, lipiec 2026).
Skąd AI Overviews bierze aktualne dane?
AI Overviews i AI Mode korzystają z tego samego, zwykłego indeksu Google Search — nie z osobnego kanału danych. Google stawia jeden warunek wejścia: „a page must be indexed and eligible to be shown in Google Search with a snippet”, czyli strona musi być zindeksowana i kwalifikować się do wyświetlenia w wynikach Google ze snippetem (Google Search Central, funkcje AI a Twoja strona, grudzień 2025). Grounding w tych funkcjach to więc rozszerzenie klasycznej indeksacji, a nie nowy mechanizm wymagający odrębnego przygotowania.
Google jednocześnie ucina popularny mit o „specjalnym przygotowaniu pod AI”: „You don’t need to create new machine readable files, AI text files, or markup (…). There’s also no special schema.org structured data that you need to add” — nie trzeba tworzyć nowych plików dla AI ani dokładać specjalnego schema, żeby pojawić się w AI Overviews i AI Mode (Google Search Central, funkcje AI a Twoja strona, grudzień 2025). Znaczenie ma dostępność dla Googlebota: blokada crawlera lub brak indeksacji oznacza brak groundingu w AIO i AI Mode. Odrębna sprawa to token Google-Extended — wyłącza on trening i grounding Gemini, ale nie wpływa na Search: „does not impact a site’s inclusion in Google Search nor is it used as a ranking signal” (Google Search Central, crawlery Google, lipiec 2026). Ustawienie Google-Extended nie wypisuje więc strony z AI Overviews. Czym są same AI Overviews, tłumaczymy w tekście czym są AI Overviews.
Co grounding znaczy dla widoczności marki?
Wniosek jest jeden: żeby model mógł Cię zacytować, musisz być w indeksie, który on odpytuje — a ten indeks nie jest tożsamy z rankingiem Google. Chatboty z wyszukiwaniem cytują w większości strony spoza czołówki: tylko 12% cytowanych linków było w top-10 Google, a około 80% cytowanych adresów nie rankowało w Google nigdzie dla oryginalnego zapytania; najbliżej rankingu był Perplexity (28,6% cytowań z top-10) (Ahrefs, sierpień 2025). Zależność ta słabnie też w czasie: udział cytowań AI Overviews pochodzących z top-10 Google spadł z 76,1% w lipcu 2025 do 37,9% w marcu 2026, bo grounding coraz szerzej sięga poza czołówkę (tzw. query fan-out) (Ahrefs, marzec 2026).
Jest przy tym twardy próg techniczny doboru: główne crawlery AI pobierają pliki JavaScript, ale ich nie wykonują. Wniosek badania brzmi wprost: „None of the major AI crawlers currently render JavaScript” (Vercel i MERJ, grudzień 2024). Treść krytyczna renderowana wyłącznie po stronie klienta jest dla groundingu niewidoczna (wyjątkiem pozostaje ekosystem Google i AppleBot) — kluczowe fakty muszą być w HTML zwróconym przez serwer. Więcej o tym progu piszemy w tekście JavaScript a boty AI. Poniższa tabela zbiera, przez co grounduje się każdy silnik i co oznacza brak w danym indeksie.
| Silnik generatywny | Indeks groundingu | Co oznacza brak w indeksie |
|---|---|---|
| ChatGPT search | Bing + własny indeks OAI-SearchBot + zewnętrzni dostawcy | Opt-out OAI-SearchBot = brak w odpowiedziach wyszukiwania ChatGPT |
| Microsoft Copilot | Wyłącznie Bing | Brak indeksacji w Bing = brak w Copilocie |
| Perplexity | Własny indeks PerplexityBot | Blokada PerplexityBot = brak w wynikach Perplexity |
| Google AI Overviews / AI Mode | Zwykły indeks Google Search | Brak indeksacji lub blokada Googlebota = brak groundingu |
| Claude (wyszukiwanie) | Własny indeks Claude-SearchBot | Blokada Claude-SearchBot = brak w wyszukiwaniu Claude |
Jak upewnić się, że jesteś w indeksie groundingu?
Wejście do groundingu to najpierw kwestia dostępności technicznej, dopiero potem treści. Zanim zaczniesz optymalizować cytowalność, upewnij się, że boty groundingu w ogóle mogą pobrać i zaindeksować Twoje strony:
- Przepuść boty groundingu w robots.txt. Odblokuj co najmniej OAI-SearchBot, bingbot, PerplexityBot, Claude-SearchBot i Googlebota — blokada któregokolwiek zamyka odpowiedni kanał widoczności (OpenAI, dokumentacja botów, lipiec 2026).
- Serwuj kluczowe treści w HTML z serwera. Crawlery AI nie wykonują JavaScriptu, więc fakty renderowane wyłącznie po stronie klienta są dla groundingu niewidoczne (Vercel i MERJ, grudzień 2024).
- Zadbaj o indeksację w Bing i w Google. Bing to warunek konieczny widoczności w Copilocie i istotny kanał groundingu ChatGPT; zwykły indeks Google zasila AI Overviews (Microsoft, dokumentacja Microsoft 365 Copilot, maj 2026).
- Nie licz na „pliki dla AI” jako skrót. Do AI Overviews i AI Mode Google nie wymaga specjalnego schema, plików AI ani markupu — liczy się zwykła indeksowalność (Google Search Central, funkcje AI a Twoja strona, grudzień 2025).
Bycie w indeksie i nawet bycie cytowanym nie gwarantuje jeszcze, że nazwa marki padnie w treści odpowiedzi. Aż 61,7% cytowań AI to „ghost citations” — link do źródła jest, ale marka w tekście odpowiedzi się nie pojawia; tylko 38,3% cytowań zawiera wzmiankę marki (Semrush i Kevin Indig, czerwiec 2026). Grounding daje więc wejściówkę do gry, ale cytowany link i wymieniona marka to dwa różne zwycięstwa, które trzeba wypracować osobno. Jeśli chcesz wiedzieć, w których indeksach i odpowiedziach Twoja marka jest dziś obecna, a w których jej brak, to właśnie mierzy audyt widoczności w AI Vistrix Labs. Szerszy obraz układania treści pod te silniki znajdziesz w przewodniku po Generative Engine Optimization.
Model nie pamięta świeżych faktów — pobiera je z indeksu w chwili odpowiedzi. Dlatego widoczność w silnikach generatywnych zaczyna się nie od jakości treści, lecz od jednego binarnego warunku: czy jesteś w indeksie, który model odpytuje. Poza tym indeksem najlepszy tekst nie istnieje.
FAQ
Czym różni się grounding od treningu modelu?
Trening to jednorazowe „nauczenie” modelu na zamrożonym zbiorze danych — ta wiedza szybko się starzeje. Grounding to osobny proces: w momencie odpowiedzi model dobiera bieżące strony z indeksu lub wyszukiwarki i opiera na nich odpowiedź (Microsoft, dokumentacja Microsoft 365 Copilot, maj 2026). Że to dwa różne mechanizmy, widać po botach OpenAI: GPTBot pobiera dane do treningu, a OAI-SearchBot buduje indeks wyszukiwania ChatGPT (OpenAI, dokumentacja botów, lipiec 2026).
Czy muszę być w indeksie Bing, żeby pojawić się w ChatGPT i Copilocie?
Dla Copilota tak — Microsoft 365 Copilot jest groundowany wyłącznie przez Bing, więc bez indeksacji w Bing strona się w nim nie pojawi (Microsoft, dokumentacja Microsoft 365 Copilot, maj 2026). Dla ChatGPT Bing jest istotnym, ale już nie jedynym kanałem: OpenAI ma własny indeks OAI-SearchBot i zewnętrznych dostawców — a strona wykluczona z OAI-SearchBot nie pojawi się w odpowiedziach wyszukiwania ChatGPT (OpenAI, dokumentacja botów, lipiec 2026).
Czy do AI Overviews potrzebuję specjalnego schema albo pliku dla AI?
Nie. Google deklaruje wprost, że do AI Overviews i AI Mode nie trzeba tworzyć nowych plików dla AI ani dokładać specjalnego schema — strona musi jedynie być zindeksowana i kwalifikować się do wyświetlenia w Google Search ze snippetem (Google Search Central, funkcje AI a Twoja strona, grudzień 2025). Kluczowa jest dostępność dla Googlebota: blokada crawlera lub brak indeksacji oznacza brak groundingu w tych funkcjach.
