Dlaczego crawlery AI nie widzą treści renderowanej JavaScriptem?
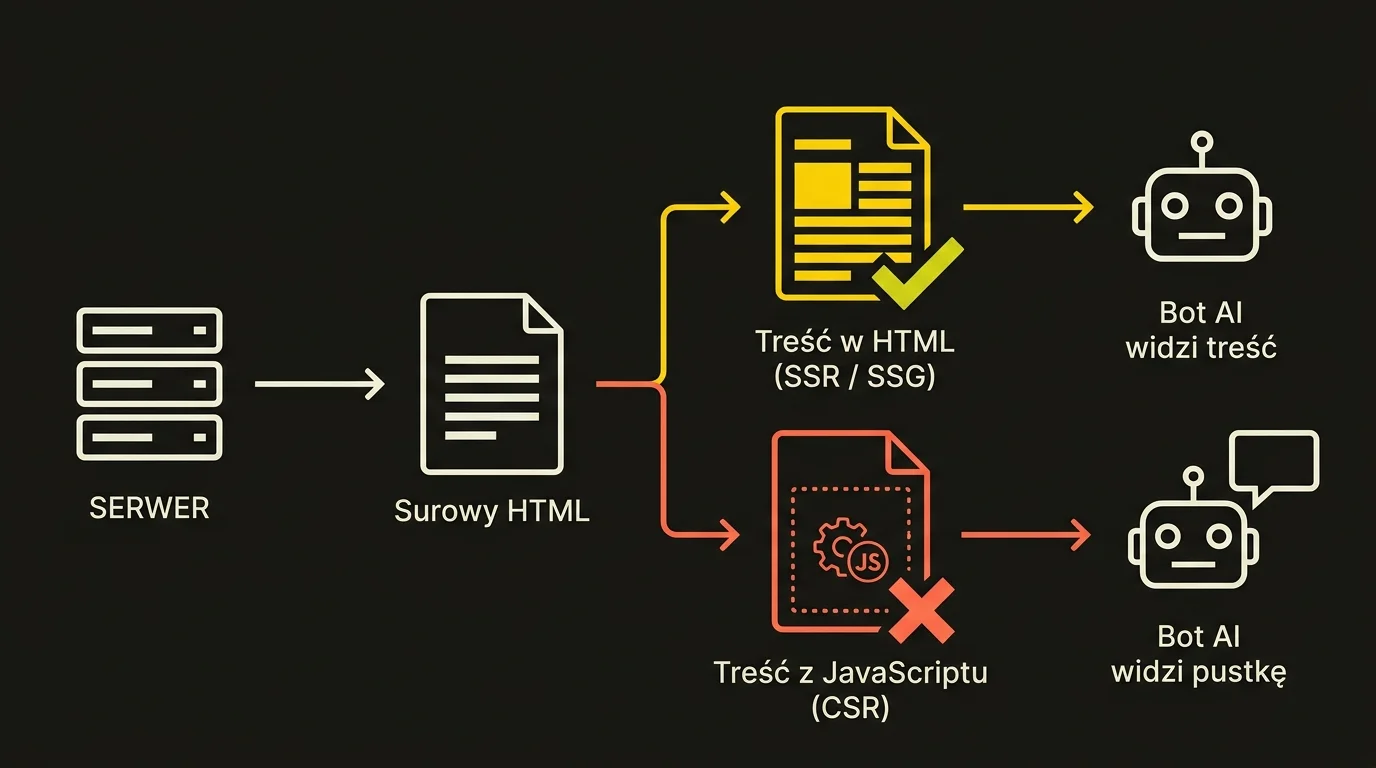
Crawlery AI nie widzą treści renderowanej wyłącznie po stronie klienta, ponieważ żaden z głównych botów AI nie wykonuje JavaScriptu — czytają tylko surowy HTML, który serwer odda w pierwszej odpowiedzi. Potwierdza to analiza logów serwerowych: w badaniu Vercel i MERJ (2024), obejmującym m.in. 569 mln żądań GPTBota i 370 mln żądań botów Claude miesięcznie, żaden z głównych crawlerów AI — GPTBot, OAI-SearchBot i ChatGPT-User (OpenAI), ClaudeBot (Anthropic), Meta-ExternalAgent (Meta) oraz Bytespider (ByteDance) i PerplexityBot (Perplexity) — nie renderował JavaScriptu.
Konsekwencja jest prosta i kosztowna: jeśli Twoja oferta, opis usługi, specyfikacja produktu albo treść artykułu doładowuje się dopiero po uruchomieniu skryptu w przeglądarce, dla silnika generatywnego — systemu odpowiadającego użytkownikowi wygenerowaną odpowiedzią zamiast listą linków (ChatGPT, Perplexity, Google AI Overviews, Copilot) — ta treść po prostu nie istnieje. Bot nie może zacytować czegoś, czego nigdy nie zobaczył.
To nie jest niszowy przypadek brzegowy. Autorzy badania podsumowali, że na ponad 500 mln fetchy GPTBota nie znaleźli ani jednego dowodu wykonania JavaScriptu (Vercel + MERJ, 2024). Ten sam problem opisujemy w kategoriach strategii w naszym przewodniku po GEO (Generative Engine Optimization), czyli metodzie tworzenia i optymalizacji treści tak, aby były cytowane w odpowiedziach generowanych przez AI.
Co dokładnie boty AI robią z Twoim JavaScriptem?
Boty AI pobierają pliki JavaScript, ale ich nie uruchamiają — pobranie pliku .js nie oznacza jego wykonania. W badaniu Vercel i MERJ (2024) GPTBot pobierał pliki JS w 11,50% żądań, a ClaudeBot w 23,84% — mimo to w żadnym z ponad 500 mln żądań nie pojawił się dowód uruchomienia tego kodu. Fakt, że w logach widać ruch na plikach .js, to najczęstsze źródło fałszywego spokoju: „bot pobiera moje skrypty, więc pewnie renderuje” jest wnioskiem błędnym.
Różnica między pobraniem a wykonaniem jest fundamentalna. Crawler AI czyta dokument HTML tak, jak przychodzi z serwera, i nie czeka na to, co zwykła przeglądarka zrobiłaby dopiero po pobraniu bundle’a JS, odpytaniu API i hydratacji strony. Jak ujęli to autorzy badania: crawlery AI nie potrafią odczytać treści renderowanej po stronie klienta, a „to, co jest w surowym HTML, to wszystko, co mają” (Vercel + MERJ, 2024).
W praktyce dzieli to strony na dwa światy. Treść renderowana po stronie serwera (SSR — server-side rendering, generowanie gotowego HTML na serwerze przed wysłaniem do przeglądarki) jest dla botów widoczna od razu. Treść renderowana wyłącznie po stronie klienta (CSR — client-side rendering, budowanie zawartości w przeglądarce przez JavaScript) jest dla nich pustką. Najbardziej narażone są aplikacje jednostronicowe (SPA) zbudowane w frameworkach frontendowych, gdzie serwer zwraca niemal pusty szkielet HTML, a całą treść dorysowuje dopiero JavaScript po stronie użytkownika — dla crawlera AI taka strona jest praktycznie biała.
Które boty AI renderują JavaScript, a które nie?
Jedynym dużym wyjątkiem jest ekosystem Google: Googlebot renderuje i wykonuje JavaScript w headless Chromium, a AI Overviews oraz Gemini dziedziczą tę infrastrukturę wyszukiwarki. Wszystkie pozostałe główne crawlery AI JS-a nie renderują — i stan ten w 2026 roku się nie zmienił (Passionfruit, 2026). Poniższa tabela zestawia deklarowane zachowanie najważniejszych botów.
| Crawler | Właściciel | Wykonuje JavaScript? |
|---|---|---|
| Googlebot (AI Overviews, Gemini) | Tak — headless Chromium, pełne renderowanie | |
| GPTBot, OAI-SearchBot, ChatGPT-User | OpenAI | Nie |
| ClaudeBot, Claude-SearchBot | Anthropic | Nie |
| PerplexityBot | Perplexity | Nie |
| Meta-ExternalAgent | Meta | Nie |
| Bytespider | ByteDance | Nie |
Uwaga na pułapkę myślową: „skoro Google renderuje JS, to jestem bezpieczny” jest zawodne z dwóch powodów. Po pierwsze, Google to tylko jeden kanał — ChatGPT, Perplexity i Copilot pozostają ślepe na Twoją treść klientową. Po drugie, nawet u Google renderowanie JavaScriptu jest odroczone do osobnego etapu: proces dzieli się na crawling, rendering i indexing, a strona czeka w kolejce renderowania (Google Search Central, 2026). JavaScript opóźnia i komplikuje indeksację nawet tam, gdzie jest wspierany.
Jak sprawdzić, co bot AI widzi na Twojej stronie?
Najprostszy test polega na obejrzeniu surowego HTML bez wykonywania JavaScriptu — dokładnie tego, co dostaje crawler AI. Jeśli w tym widoku brakuje krytycznej treści, bot jej nie zobaczy (Vercel + MERJ, 2024). Cztery sposoby, od najszybszego:
- curl w terminalu. Komenda
curl -s https://twojadomena.pl/stronazwraca surowy HTML z serwera, bez uruchamiania żadnego skryptu. Poszukaj w wyniku swojego nagłówka, akapitów oferty i kluczowych faktów — jeśli ich nie ma, nie zobaczy ich też crawler AI. - Podgląd źródła strony. W przeglądarce „Wyświetl źródło strony” (view-source) pokazuje ten sam surowy dokument, zanim JavaScript go przebuduje. To nie to samo, co inspektor elementów, który prezentuje już wyrenderowany DOM.
- Wyłączony JavaScript. Wyłącz wykonywanie JS w ustawieniach przeglądarki i odśwież stronę. Puste sekcje, znikające opisy i „szkielet” bez treści to dokładnie to, co widzą boty AI.
- Narzędzia Google. URL Inspection Tool w Search Console oraz Rich Results Test pokazują wyrenderowany HTML — czyli to, co bot Google widzi po wykonaniu JavaScriptu; Google oficjalnie zaleca oba do weryfikacji (Google Search Central, 2026).
Zestawienie widoków jest diagnostyczne: jeśli treść jest w narzędziach Google, ale znika w curl i przy wyłączonym JS, masz klasyczny problem renderowania klientowego — widoczny dla Google, niewidoczny dla crawlerów AI.
Dla crawlera AI Twoją stroną jest surowy HTML, który zwraca serwer — nie to, co przeglądarka pokaże użytkownikowi po wykonaniu JavaScriptu. Jeśli krytycznej treści nie ma w tym pierwszym dokumencie, dla silnika generatywnego ona nie istnieje.
Jak naprawić stronę, żeby boty AI widziały treść?
Naprawa jest jednoznaczna: krytyczna treść musi trafiać do początkowej odpowiedzi HTML z serwera — przez SSR, SSG lub prerendering — zamiast doładowywać się po stronie klienta (Vercel + MERJ, 2024). Chodzi o to, by bot dostał gotowy dokument z całą treścią już w pierwszym żądaniu, bez potrzeby uruchamiania czegokolwiek.
- SSR (server-side rendering). Serwer generuje pełny HTML dla każdego żądania. Najlepsze dla treści dynamicznej i często zmienianej — bot i użytkownik dostają kompletną stronę od razu.
- SSG (static site generation). Strony budowane są z góry, przy deployu, do statycznych plików HTML. Idealne dla treści, która nie zmienia się przy każdym wejściu: artykułów, opisów usług, dokumentacji.
- Prerendering. Warstwa pośrednia serwuje botom wcześniej wyrenderowany HTML, podczas gdy użytkownicy dostają wersję klientową. Rozwiązanie ratunkowe dla istniejących aplikacji SPA, których nie da się szybko przebudować.
Zasada nadrzędna jest niezależna od wybranej techniki: cokolwiek uznajesz za krytyczne dla cytowania — nazwa marki, oferta, fakty, liczby, dane kontaktowe — musi znaleźć się w surowym HTML, a nie doładowywać przez API po stronie klienta. Kompletny zestaw kroków technicznych — renderowanie, dostępność treści dla botów, sitemapy, robots.txt — rozpisujemy w przewodniku jak przygotować stronę na silniki generatywne.
Jeśli nie wiesz, czy Twoja treść jest widoczna dla botów AI, zacznij od pomiaru: audyt widoczności w AI pokazuje, co crawlery faktycznie odczytują z Twoich stron i które sekcje giną przy renderowaniu klientowym, zanim naprawa trafi do backlogu deweloperów.
Czy przeglądarki agentowe AI nie rozwiązują tego problemu?
Nie, przeglądarki agentowe AI nie zastępują crawlerów indeksujących. Narzędzia takie jak ChatGPT Atlas czy Perplexity Comet wykonują JavaScript, ale są interaktywnymi sesjami uruchamianymi przez konkretnego użytkownika w konkretnym momencie — nie botami, które systematycznie indeksują sieć (Vercel + MERJ, 2024). To, że agent na żądanie użytkownika odczyta Twoją stronę klientową, nie oznacza, że trafi ona do indeksu, z którego silnik czerpie odpowiedzi dla wszystkich pozostałych zapytań.
Innymi słowy: widoczność w odpowiedziach ChatGPT, Perplexity czy Copilot dla anonimowego pytania zależy od tego, co zebrały crawlery indeksujące — a te JavaScriptu nie renderują. Przeglądarka agentowa to pojedyncza wizyta, a nie kanał budowania obecności marki w silnikach generatywnych. Jak silniki wybierają, co pokazać w odpowiedzi, wyjaśniamy w tekście jak ChatGPT wybiera źródła.
FAQ: JavaScript i boty AI
Czy Google widzi treść renderowaną JavaScriptem?
Tak, ale z opóźnieniem. Googlebot renderuje JavaScript w headless Chromium, a AI Overviews i Gemini korzystają z tej samej infrastruktury. Renderowanie jest jednak odroczone do osobnego etapu po pobraniu strony — proces to crawling, rendering i indexing, a strona czeka w kolejce renderowania (Google Search Central, 2026). Google to zarazem jedyny duży wyjątek: ChatGPT, Perplexity i Copilot JavaScriptu nie wykonują.
Czy skoro boty pobierają moje pliki .js, to je uruchamiają?
Nie. Pobranie pliku to nie to samo, co jego wykonanie. W badaniu Vercel i MERJ (2024) GPTBot pobierał pliki JS w 11,50% żądań, a ClaudeBot w 23,84% — mimo to na ponad 500 mln żądań nie znaleziono ani jednego dowodu uruchomienia JavaScriptu. Ruch na plikach .js w logach nie oznacza, że bot widzi treść generowaną przez te skrypty.
Jak najszybciej sprawdzić, co widzi crawler AI?
Uruchom curl -s https://twojadomena.pl/strona albo wyłącz JavaScript w przeglądarce i odśwież stronę — oba widoki pokazują surowy HTML z serwera, czyli dokładnie to, co dostaje crawler AI (Vercel + MERJ, 2024). Jeśli brakuje w nim krytycznej treści, bot jej nie zobaczy, a naprawą jest przeniesienie renderowania na serwer (SSR, SSG lub prerendering).